

 技术经理人
 行业专家
 技术经理人
 行业专家
SpecVLM(无损加速视频理解大模型推理技术)
 合作区域:
 拟投入总金额: 万元
 所属地域: 宁海县
 技术领域: 新应用领域中的基础研究
技术交易金额: 100.0万元
 发布日期: 2026-09-20
 登录后查看。
 信息描述
技术简介:
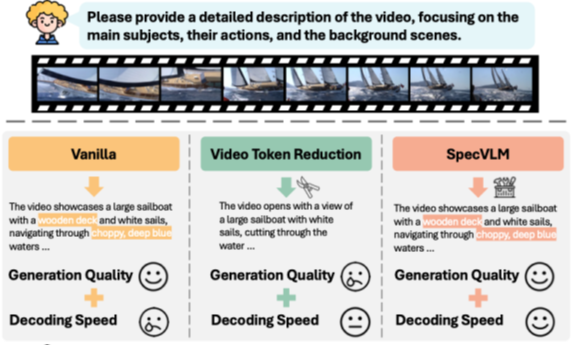
视频语言大模型由于巨量的模型参数和输入规模,在推理阶段面临性能挑战。本成果(SpecVLM)解决了现有加速技术固有的生成质量损失问题,实现了无损地加速视频语言大模型的推理。同时,本成果结合推测解码技术显著降低了解码延迟,实现了高推理加速比,为计算资源受限的应用场景赋能。
(1)原生的视频理解大模型:虽然生成质量较优,但是由于庞大的显存和视频开销,导致推理速度很慢。
(2)传统的剪枝加速技术:虽然一定程度提高了推理速度,但是以生成质量为代价,且无法获得显著加速。
(3)本成果(SpecVLM)技术:通过结合推测解码技术,在参数+视频输入两个维度联合优化,没有任何质量损失的同时,实现了最高达2.68倍的推理解码加速比。
专利信息:
| 专利所属地区 | 专利类型 | 专利号/申请号/登记号 | 专利授权日期 | 专利证书图片 |
|---|---|---|---|---|
| 中国 | 发明专利 | 202511079509.4 |
微信扫码⇒移动端
微信扫码⇒公众号