

 技术经理人
 行业专家
 技术经理人
 行业专家
 合作区域:
 拟投入总金额:
 所属地域:
 技术领域:
 发布日期:
 登录后查看。
 信息描述
技术简介:
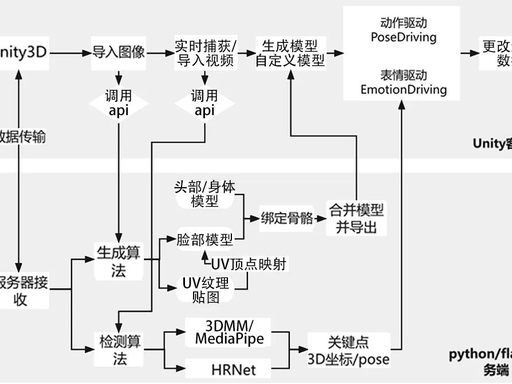
项目自研技术包含三项关键技术,包括基于语音生成高精度三维表情参数技术,基 于语音生成自然稳定的三维头部动作参数技术,基于三维头部动作参数和三维表情参数 驱动人脸图像生成说话视频技术。通过对这三大模块进行结合,可以获得一个直接通过 语音驱动说话人脸视频生成的系统。目前该系统已基本实现。
微信扫码⇒移动端
微信扫码⇒公众号